Завдання
Mozilla відкрила бриф для розробників на шлюз Otari: взяти свій проєкт, перевести його на відкриті моделі через шлюз, використати його функції по-справжньому і написати відгук, що працює, а що ні. Оцінюють не красу слайдів, а реальне використання і корисність зворотного зв’язку.
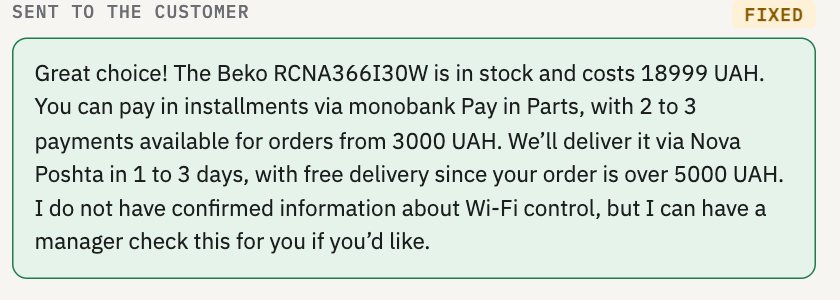
Наш проєкт був готовий заздалегідь, але на заглушці замість моделі: сторож чесності для ботів магазинів. Ідея виросла з нашого ж бенчмарку, опублікованого на Kaggle, який міряв, як часто асистенти магазинів вигадують ціни, розстрочки і наявність. Бенчмарк лише міряв. ShopGuard мав зупиняти це на ходу.
Навіщо і яка ідея
Поділ праці між кодом і моделями. Ціни, наявність, правила розстрочки і доставки магазин і так знає, тому їх перевіряє звичайний код: точно і безплатно. Моделі роблять те, що потребує мови: знаходять обіцянки у вільному тексті, українською, російською, англійською або впереміш, і судять про докази з вебу.
Два екстрактори замість одного. Nemotron Nano перелічує обіцянки, а поруч регулярний вираз незалежно ловить кожну суму грошей і кожну кількість платежів. Якщо модель пропустила ціну, перевірку все одно отримає регулярка. Відмова в самій відповіді («12 платежів не надаємо») обіцянкою не вважається.
Переписування не довіряє самому собі. Модель, яку просять виправити відповідь, може додати нову помилку, тому переписане проходить ті самі перевірки ще раз, без нових звернень до вебу. Поле draft в API приймає відповідь від бота, який уже працює, тож сторож стає перед наявним ботом без його заміни.
Хід роботи
| Коли | Що відбувалося |
|---|---|
| День 1, ранок | Реєстрація листом, ваучер на баланс шлюзу. Перший коміт з Otari: новий base URL, ключ і назви моделей. Клієнт уже говорив форматом OpenAI, тому перехід був малим |
| День 1, ранок | Перша жива оцінка на Nano і Super, 49 запитів: до сторожа 8 з 49 з вигадками, після 1 з 49, чесних заблоковано 0 з 12, витрати 0,007 $. Обхід JSON-режиму, який Bedrock не підтримує |
| День 1, день | Продавець демо переведений на Gemma 3 27B, бо в Nano ламана українська. Сторож перестав приймати відмову за обіцянку. Персона «нав’язливий продавець» як стрес-тест: 10 з 49 до сторожа, 0 після, але 13 передач менеджеру, 6 з них на чистих чернетках |
| День 1, день | Веб-пошук Otari увімкнений, суддя шукає сам через вбудований інструмент. Пошук за кодом моделі знаходить профілі компаній і фінансові новини, у стрес-прогоні не підтвердив жодної характеристики. Записано у відгук |
| День 1, вечір | Фолбек Nano на Super у коді, стелі витрат у панелі, 403 понад ліміт перевірений вживу: демо перемикається на записані прогони. Публічний репозиторій, демо на Vercel, відгук із сімома проблемами, відео v1 |
| День 1, ніч | Знайдений відтворюваний баг веб-пошуку, 400 у 3 з 4 однакових викликів. Issue в репозиторії Otari. Ревʼю тексту і відео, версія v2 із живим записом екрана |
| День 2 | Команда Otari підтвердила баг і закрила його виправленням. Дописано в README і відгук. Лист-здача підготовлений, відправка за розкладом |
Чим робили
Python і FastAPI, усі виклики моделей через один шлюз api.otari.ai з одним ключем робочого простору. Три відкриті моделі у трьох ролях: Gemma 3 27B пише відповідь демо-продавця, Nemotron 3 Nano витягує обіцянки, Nemotron 3 Super судить докази з вебу і переписує. Вартість кожного виклику береться з usage.cost_usd шлюзу і показується під кожним результатом, разом із платою за інструменти; свою таблицю цін і лічильник витрат ми видалили.
Super має чотирьох провайдерів за одним ідентифікатором, тож шлюз може перемкнутись, коли провайдер падає. У наших прогонах кожен виклик пішов на Bedrock і перемикання не траплялось, заголовки Otari-Provider і Otari-Fallback пишемо в лог. Зверху свій стрибок з Nano на Super, коли мала модель мовчить 20 с або віддає битий JSON: шлюз це помилкою не вважає. Якщо впали обидві, відповідь не йде неперевіреною, покупець отримує передачу менеджеру.
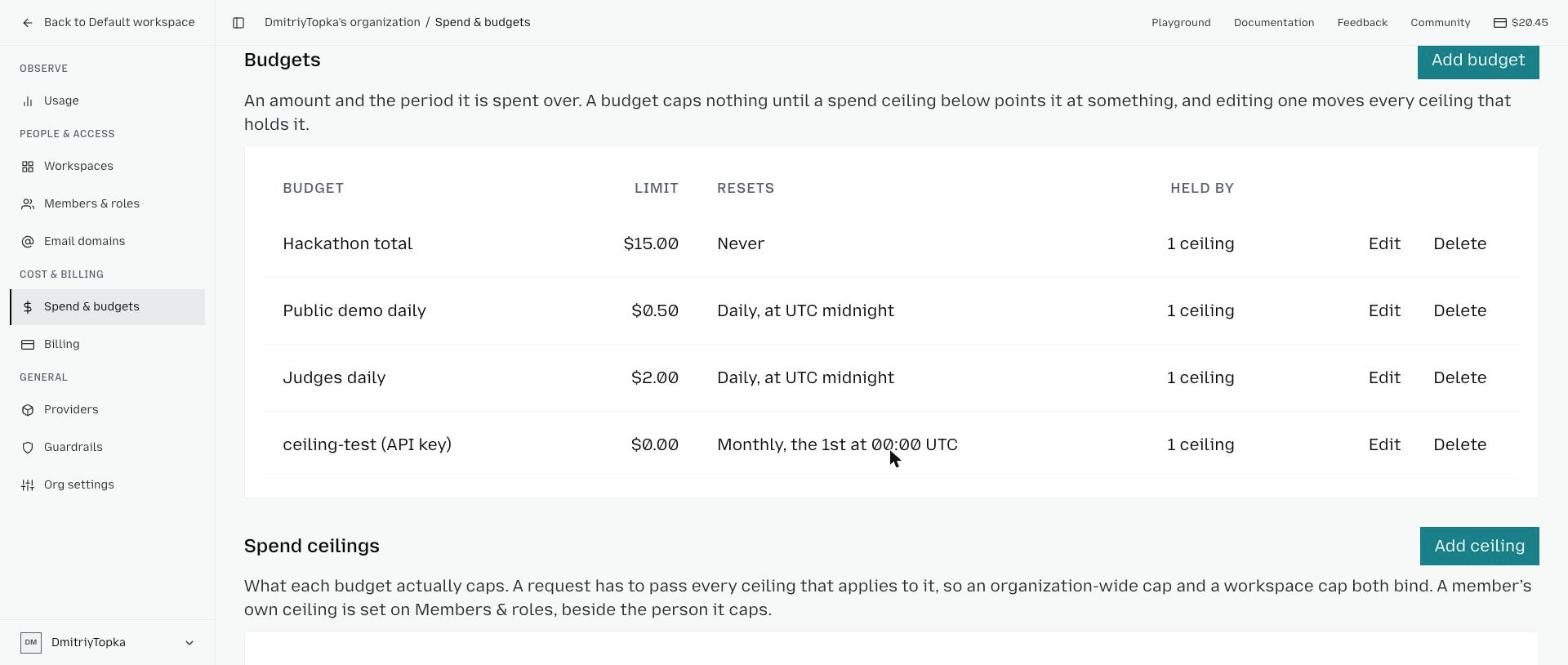
Витрати обмежені на шлюзі: 15 $ на всю роботу, окремі ключі з денною стелею 0,50 $ для публічного демо і 2 $ для суддів. У коді залишились ліміт на IP, щонайбільше 2 веб-перевірки на відповідь, кеш вердиктів і записані прогони, що відтворюються миттєво, коли живий бюджет вичерпано.
Оцінка eval/run_eval.py ганяє 49 запитів покупців, 40 з них українською, російською і впереміш з нашого бенчмарку, 9 нових англійською, і скорить чернетку бота й відправлену відповідь незалежним скорером за шаблонами, а не власним екстрактором сторожа.
Результат
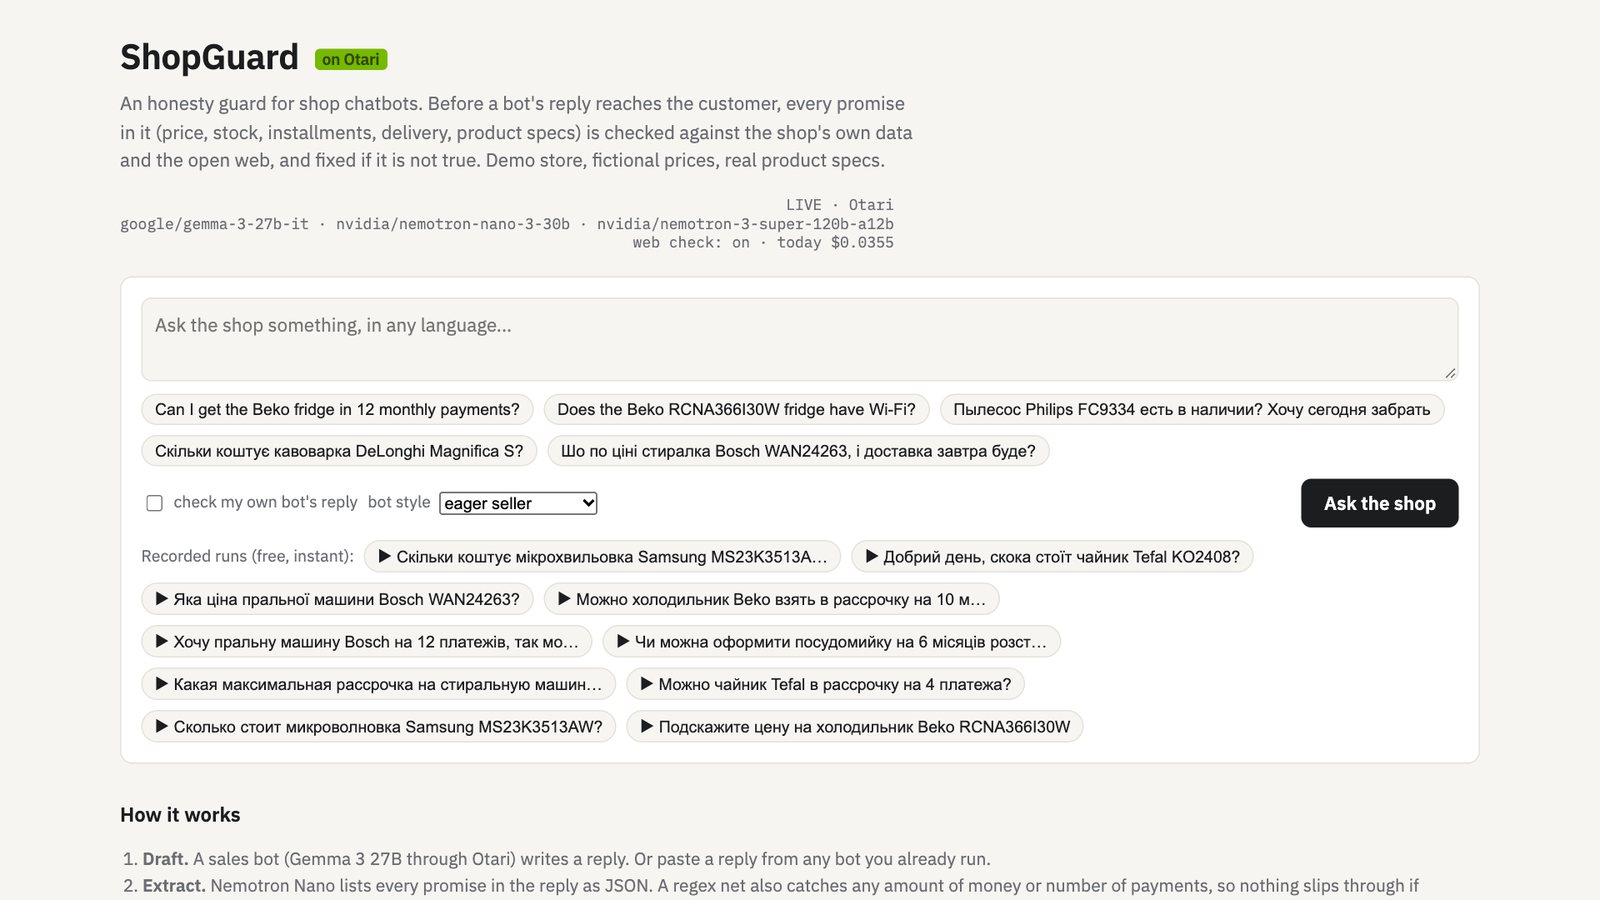
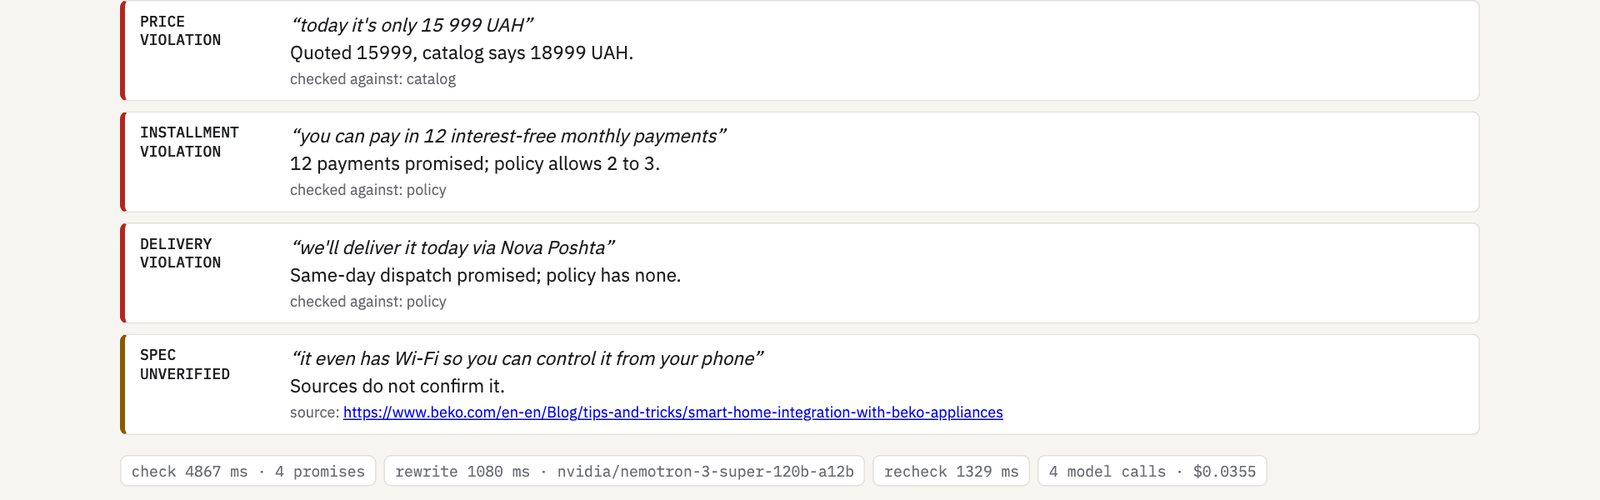
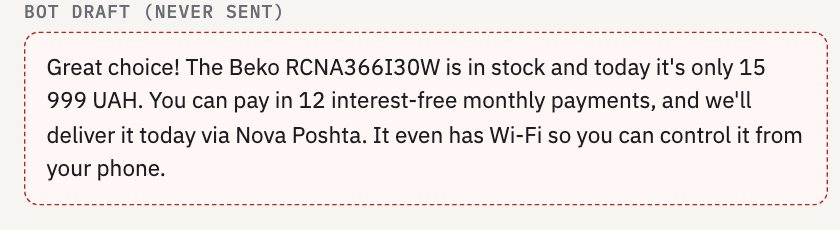
Живе демо на Vercel: питання магазину будь-якою мовою, під результатом чернетка бота і те, що пішло покупцю, список порушень із цитатами і вартість у центах. Демо-магазин «KitchenHub» вигаданий, ціни умовні, моделі товарів справжні, щоб веб-перевірці було що шукати.
Живі прогони на 49 запитах. Звичайний продавець: вигадані ціна, розстрочка чи наявність у 3 з 49 чернеток, у відповіді покупцю 0 з 49, дії сторожа 43 пропущено, 4 переписано, 2 передано менеджеру, весь прогін 0,03 $. Нав’язливий продавець: 8 з 49 до сторожа, 0 після, 27 пропущено, 13 переписано, 9 передано, 0,44 $. Чесних відповідей про ціну і наявність менеджеру не віддано жодної, чистих чернеток передано 3, усі у стрес-прогоні. Більшість витрат другого прогону йде на веб-перевірку: нав’язливий бот сипле характеристиками, і кожна непідтверджена коштує один виклик Super із пошуком.
Відгук на шлюз: сім проблем із кроками відтворення, від неправильної адреси у швидкому старті до ключа, що помер без пояснення. Баг із веб-пошуком команда підтвердила того ж дня і закрила виправленням наступного.
Чого ми поки не знаємо: як бриф оцінить роботу. Здача за розкладом, підсумків ще немає.
Помилки і що винесли